Analítica y rendimiento
Los visitantes, de dónde llegaron, qué tan rápido les cargó el sitio y cuáles se volvieron clientes, leídos de un solo conjunto de números en la propia instalación del negocio. Lo que la pila de analítica de siempre no puede contestar, y la pregunta que esto le permite hacer a un dueño.
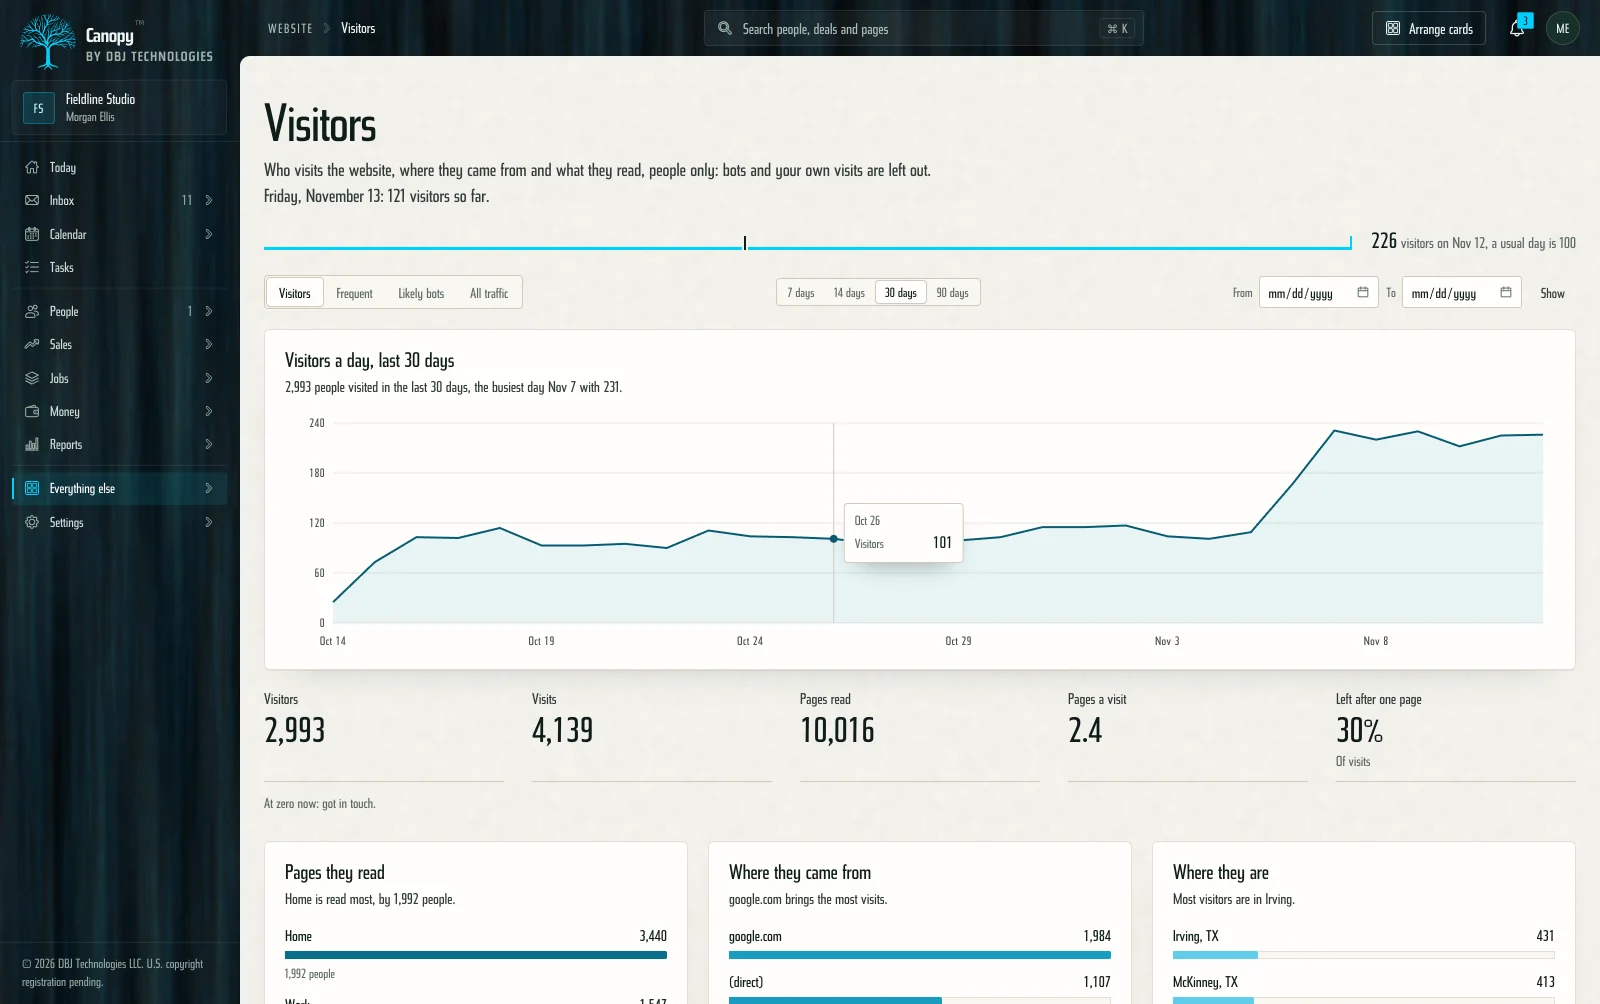
La primera pregunta que me hice al dar forma a la analítica de Canopy: qué cambia cuando los números de visitantes y los números de ventas viven en el mismo lugar. La respuesta es el tipo de pregunta que por fin puede hacer un dueño. Una herramienta de analítica típica es buena para "cuál fue mi tasa de rebote la semana pasada". No puede contestar "de los prospectos que se volvieron clientes que pagan el trimestre pasado, dónde me encontraron primero y cuánto tardaron en decidir". Las visitas viven en el software de una empresa, las ventas en el de otra, y los reportes entre las dos nunca coinciden del todo. La tasa de rebote es un indicador. Qué fuente produjo clientes que pagan es una decisión sobre dónde va el siguiente dólar de marketing, y la pila de siempre no puede tomarla. La respuesta de siempre es más software: una herramienta de analítica, un CRM, un conector entre los dos, una herramienta de atribución sobre el conector y un panel encima de todo. Varios productos, una cuenta por cada uno, y un conector entre ellos que es lo primero que se rompe. Cuando un proveedor cambia sus términos o retira una función, el dueño se queda sin ver su propio embudo hasta que alguien lo vuelva a armar. En Canopy el visitante y el cliente están en la misma instalación. Quién llegó, de dónde vino, qué buscó, qué páginas leyó, qué tan rápido le cargaron, qué formulario envió y en qué oportunidad se convirtió son una sola historia continua. La pregunta de marketing, la de velocidad y la de ventas se contestan con los mismos números, en el mismo lugar, detrás del mismo acceso. Los números son honestos sobre quién es una persona. Los rastreadores y los bots se cuentan aparte de las personas, así que la cifra principal es de prospectos y clientes y no de robots, y el tráfico de bots sigue ahí cuando un número se ve raro y alguien quiere saber por qué. La velocidad se guarda página por página, para que una página lenta no se esconda en un promedio sano, y una lentitud después de un cambio al sitio aparece junto a los prospectos que podría estar costando. Los resultados de búsqueda se leen en el mismo lugar, así que las búsquedas que traen gente quedan junto a lo que esa gente hizo después. Y el sitio ya lanzado de un cliente puede reportar sus visitas y formularios a la oportunidad de ese mismo cliente, para que un caso de estudio muestre resultados reales y no la captura de la gráfica de alguien más. La privacidad es la regla, no una opción. Nada se comparte con ningún otro negocio, no hay una red de rastreo entre sitios detrás, y las direcciones de los visitantes no se guardan. Eso es en parte para poder defender al negocio ante la ley de privacidad y en parte para que el dueño nunca se sorprenda con lo que hay en sus propios registros. La exclusión honesta: Canopy está hecho para un negocio pequeño con miles o decenas de miles de visitas al día, donde saber qué visitante se volvió qué cliente importa más que contar miles de millones de eventos. Una app de consumo a esa escala necesita otro producto, y otro equipo para operarlo. La consecuencia que siente el dueño: no hay una conversación trimestral sobre qué números tienen la razón, porque solo hay un conjunto de números.